固定效应模型是什么:组内变换的直观解释
更新于
固定效应模型是什么?一句话:它把每个个体固有的、不随时间变化的差异全部扣掉,只用个体内部随时间变化的那部分去估计系数,因此也叫组内估计。本站「面板模型」一次估出混合回归、随机效应和固定效应三套设定,第一张卡还会把每个变量的变异拆成组间与组内两部分。
不少读者第一次看到「组内标准差」「组间标准差」会困惑:这些数字在固定效应里到底起什么作用?下面按照现象、原因、解决步骤和确认判据说明。
固定效应模型读不懂的现象
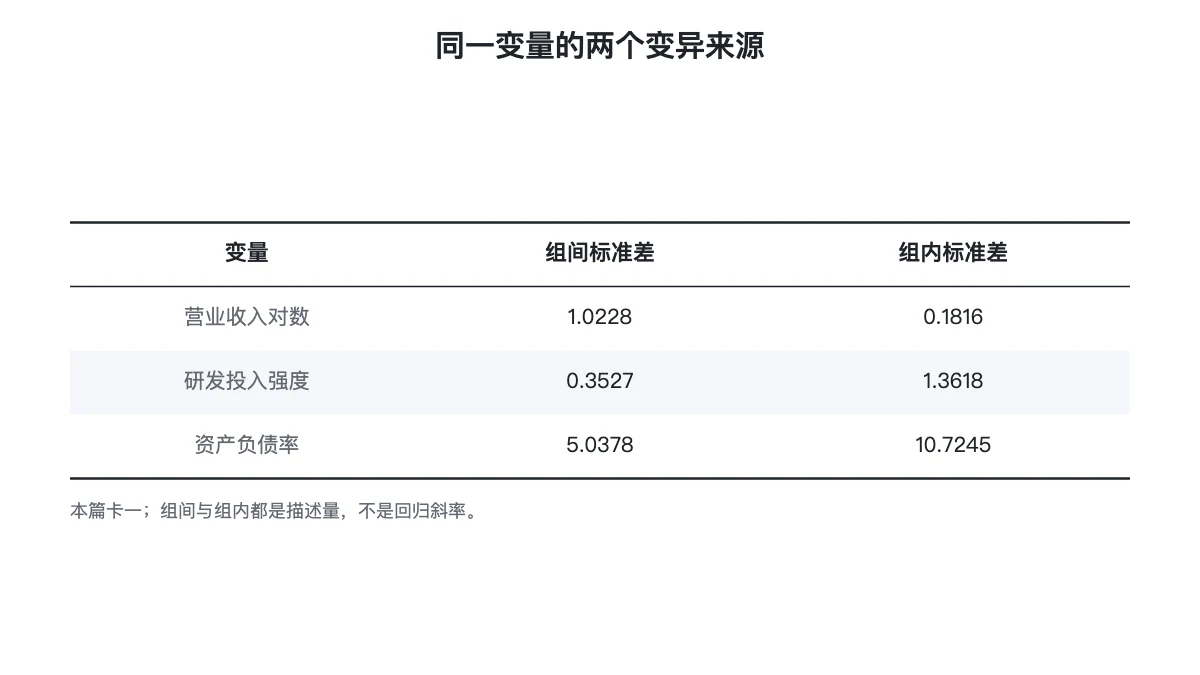
报告第一张卡的表格里,每个变量都有一个总体标准差、一个组间标准差和一个组内标准差,后面还跟着「组内变异充足,可由固定效应识别」。读者常常不知道该盯哪一列,也不明白为什么个别变量在固定效应表里找不到。
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):本例从原来的 30 家企业中整组抽取 26 家(随机种子 23),26 家企业,每家 8 期,共 208 条观测,是平衡面板。
固定效应对数据结构有两条硬要求:每个个体至少要有 2 期观测,只有 1 期时组内变换后没有任何变异,系数无法识别;随机效应则要求个体数大于自变量个数加一,否则方差分解会除零。本例每家企业 8 期,26 个个体,两条要求都满足。
固定效应是什么意思:组内变换的直观解释
可以把每家企业的长期平均水平看作自己的起点。组内估计比较的是同一企业高于或低于自己起点时,解释变量与结果变量怎样共同变化;它不会把一家企业的长期高收入直接与另一家的低收入拿来估计同一个斜率。
被减去的是各变量在企业内部的均值,并非只减因变量。假如一个属性在所有时期完全相同,它减去自己的均值后就没有变化,因而无法单独识别该属性的斜率。想研究这种属性,需要另行论证可识别它的模型,无法仅因为需要一个系数就接受随机效应假设。
组内估计还能面临随时间变化的混杂、测量误差与反向关系。吸收稳定的企业差异,并不自动消除这些问题;因此本文把回归斜率写成条件关联,研究设计没有提供的因果结论也不由固定效应名称补足。
解决步骤
- 先看第一张卡的组间与组内标准差,确认关键自变量有足够的组内变异。
- 再看三项检验:F 检验比较是否存在个体固定效应,Hausman 检验才回答固定效应还是随机效应。
- 读 FE 系数表时,把 R²(within) 当作拟合指标,别拿混合回归的 R² 去比。
先按上述顺序核对,再解释报告中的点估计。分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
怎么确认固定效应读对了
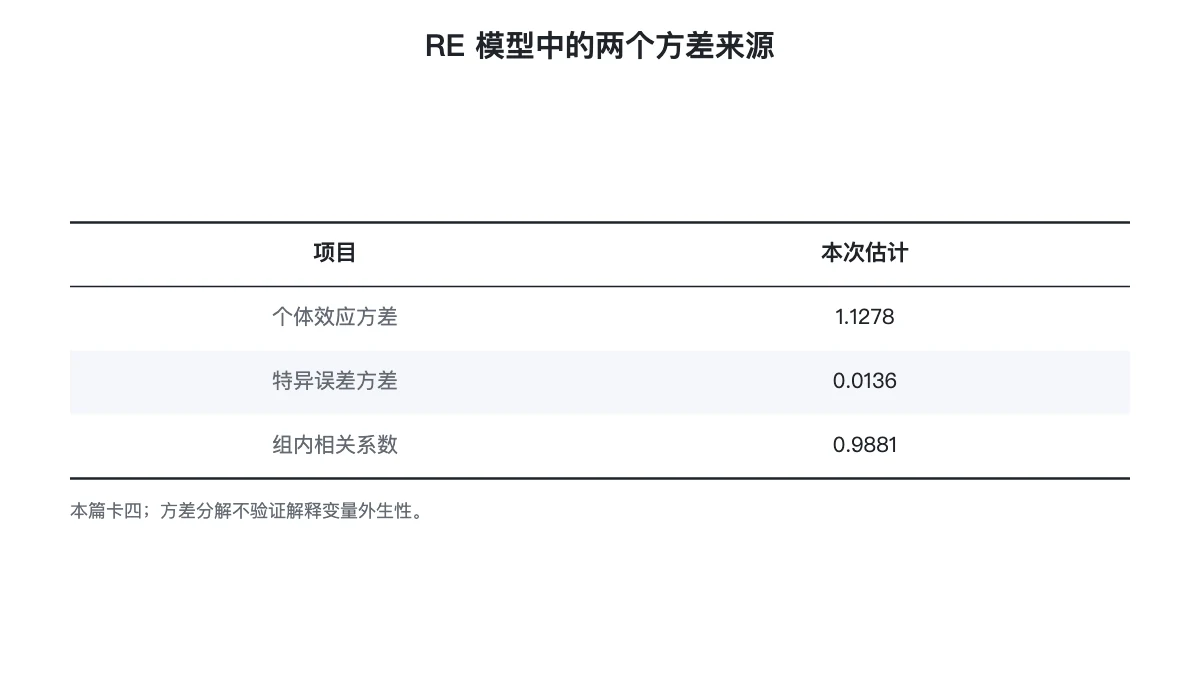
- 组内变异:因变量组内标准差 0.1816,研发投入强度与资产负债率均标注为组内变异充足。
- 检验:F 检验统计量 612.501(p<0.001),说明存在个体效应;BP-LM 统计量为 708.535,达到显著水平;Hausman 的 p>0.999,未拒绝随机效应限制,但这不是限制成立的证明。
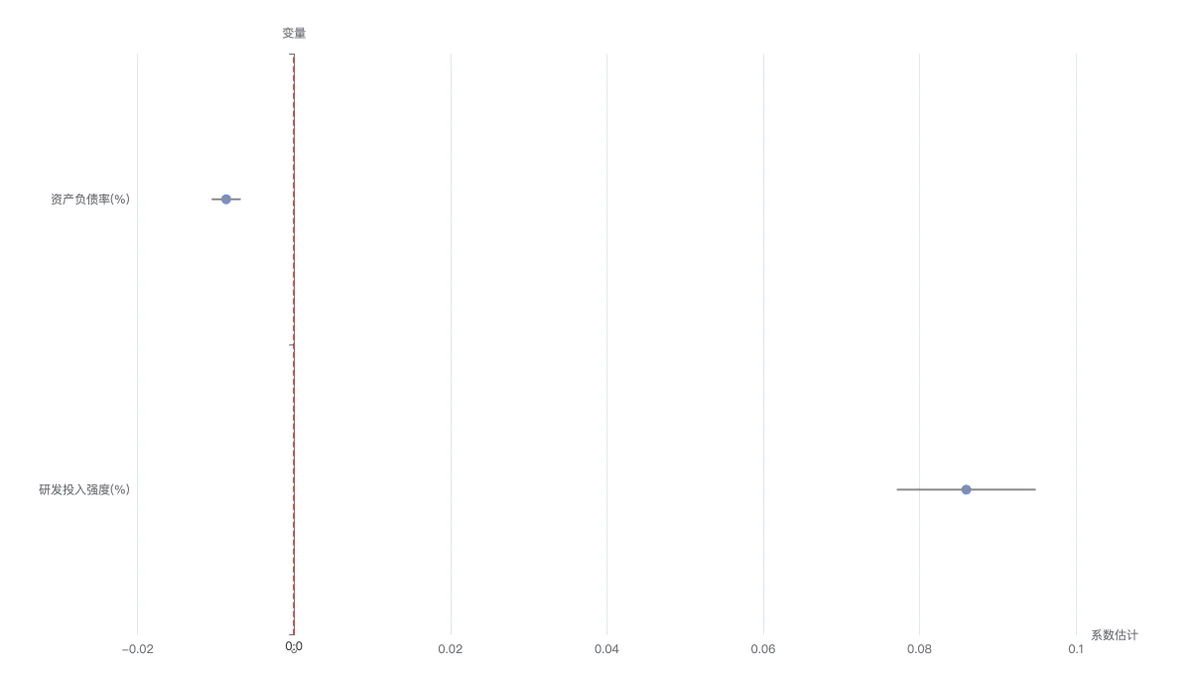
- 系数:FE 中研发投入强度(%)为 0.086(标准误 0.005),资产负债率(%)为 -0.009;两个斜率均达到显著水平。
- 拟合:FE 的 R²(within) 为 0.6412,描述组内变动被拟合的比例;这与解释企业之间长期水平差异是两个问题。
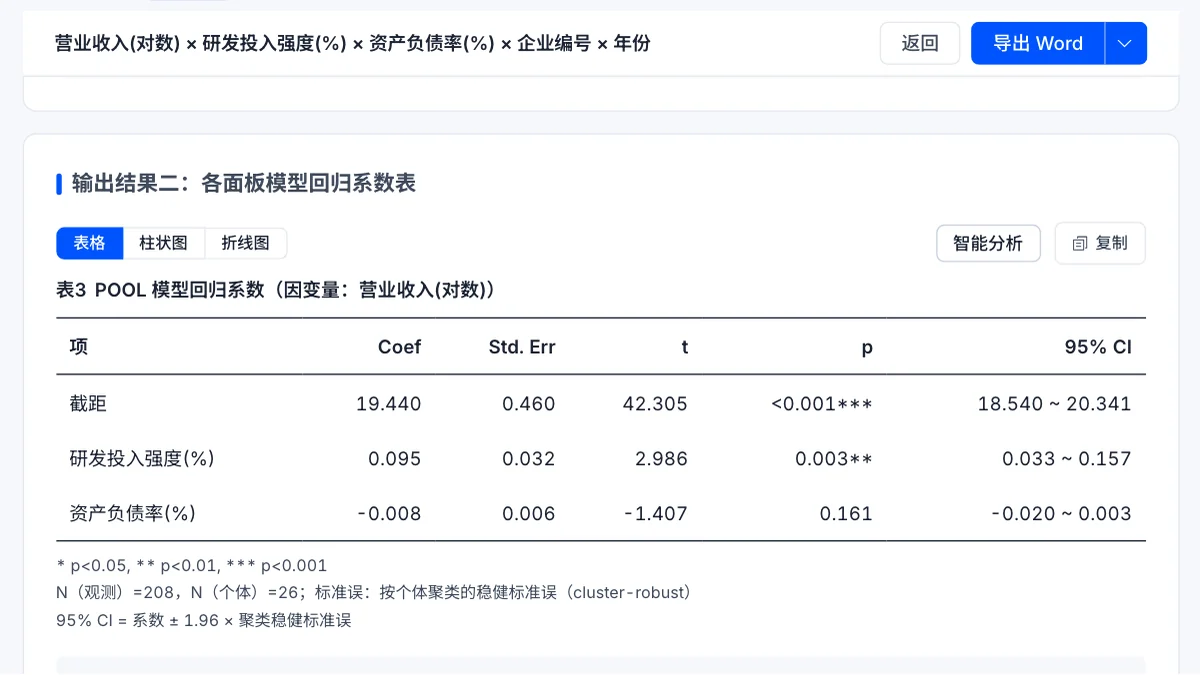
POOL 的总体拟合与组内拟合衡量不同的变异来源。比较结果前应先读清列名,并保持因变量、样本和拟合指标定义一致;无法把一列总体指标与另一列组内指标直接相减。
固定效应模型常见错误
- 把组内标准差当成系数:前者描述自变量或因变量自己的波动,后者描述控制其他变量后的关联。
- 把不显著解释成没有关联:应结合区间表达不确定性,无法接受零效应作为已证实结论。
- 把高组内拟合解释成识别可靠:模型拟合不回答遗漏变量与反向关系,研究背景仍需单独论证。
本例聚类标准误按企业分组,允许同一企业内部的误差相关。它没有取代对跨企业共同冲击的检查;报告也没有提供序列相关与横截面相关的正式检验结果,应把未检查的部分写进局限。
延伸阅读
常见问题
- 固定效应是什么意思?
- 固定效应把每个个体固有的、不随时间改变的差异扣掉,只用个体内部随时间变化的部分估计系数,所以也叫组内估计。性别、省份这类不随时间变化的变量会被一并扣掉。
- 固定效应模型为什么要看组内变异?
- 因为它只用得上组内变异。本例因变量的组间标准差为 1.0228,组内只有 0.1816;自变量的组内变异不足时,固定效应下的系数会不稳定。
- 固定效应模型的 R² 要看哪一个?
- 看 R²(within),它只衡量组内变异的解释比例。本例 FE 的 R² 与 R²(within) 都是 0.6412;不同模型的 R² 定义不同,无法跨模型直接排优劣。