双重差分论文结果怎么写:主表、平行趋势图与稳健性表
更新于
双重差分论文的结果可以先照这句写(以下数字来自本站演示数据,模拟生成,不代表真实研究结论):在控制企业规模后,交互项估计为正(估计区间不含零),但政策效应解释仍以识别假设为条件。这一句要由主表、动态效应和稳健性表三部分支撑。
一般要写明主表的样本量与聚类口径、平行趋势的统计量,以及安慰剂结果是否进表。下面按主表、平行趋势与动态效应、稳健性表和写作对照四部分说明。
did结果表的标准格式:主表怎么排
下表数字来自本站「双重差分(DID)」的真实运行。本例按企业整体随机抽取 85%(随机种子 31),共 51 家企业、306 条观测,实验组 156、控制组 150 条观测,覆盖 6 期,标准误按企业聚类。
| 变量 | 系数 | 标准误 | t |
|---|---|---|---|
| 截距 | 58.030*** | 5.982 | 9.701 |
| 处理组 Treat | 3.029* | 1.315 | 2.304 |
| 事件后 Post | 6.223*** | 0.472 | 13.181 |
| Treat × Post(净效应) | 4.263*** | 0.687 | 6.204 |
| 企业规模(对数总资产) | 2.045*** | 0.276 | 7.417 |
| N | 306 | ||
| R² / 调整 R² | 0.5006 / 0.4940 |
表注:* p<0.05,** p<0.01,*** p<0.001;标准误为按企业聚类的稳健标准误(51 个聚类)。交互项放在显眼位置,控制变量系数如实列出但不必逐个解读。
主表之外要交代三件事。其一是标准误口径:报告本次聚类数,并说明小聚类数可能影响渐近推断;本例推断自由度为 50。其二是事件时点:本次运行没有手填,系统按时间取值的中位次序推断为 2021,表注里要写明是推断值还是政策实际时点。其三是效应大小:标准化效应 δ 为 0.762,属于中等效应,相对处理组事前均值的变化率为 4.08%,两个数用来说明量级,并不取代显著性判断。
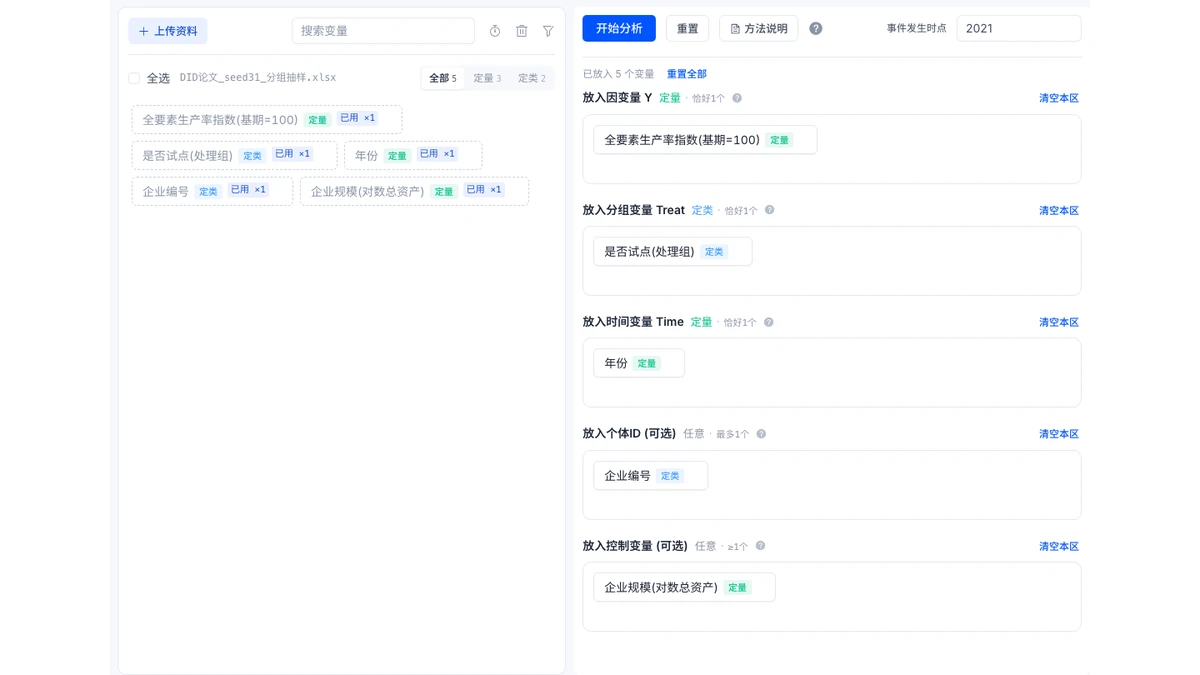
下图是本例实际工作台的变量设置,控制变量和事件时点应与论文说明一致。产生本次证据时事件时点留空,由系统推断;截图为复现核对将同一推断值 2021 显式回填,其他变量与本次运行一致。它没有把推断值当成真实政策资料。
每个数字从哪来
论文里的每个数字都能回到报告的某张卡、某张表:
| 论文里的内容 | 报告里的位置 |
|---|---|
| 主表的系数与标准误 | 卡2「DID 回归完整系数表」 |
| 样本量、实验组与控制组观测数 | 卡1「处理状态 × 事件前后的样本量分布」 |
| 平行趋势的联合检验 F 与 p | 卡1「DID 识别前提的检验结果」 |
| 逐期动态效应 | 卡4「事件研究法逐期动态效应」 |
| 稳健性与安慰剂 | 卡4「稳健性检验与安慰剂检验」 |
主表里的净效应与系数表同值,动态效应则来自卡4 另一套事件研究回归,两者不同源,无法互换。核对时按这张对照逐个回查。
分析和查看结果不用登录;登录后可以保存历史、我的数据、LaTeX 源码与单张图片导出;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
双重差分论文的平行趋势与动态效应怎么写
事前联合检验 F(2, 50)=0.188,p=0.829,写成「未发现违背平行趋势的证据」,并说明该检验只能证伪。动态效应以 2020 年为基期(固定为 0):2018 年 -0.778(p=0.565),2019 年 -0.603(p=0.611),事前两期不显著;事件后 2021 年 4.135(p<0.001),2022 年 3.644(p=0.004),2023 年 3.667(p=0.002)。
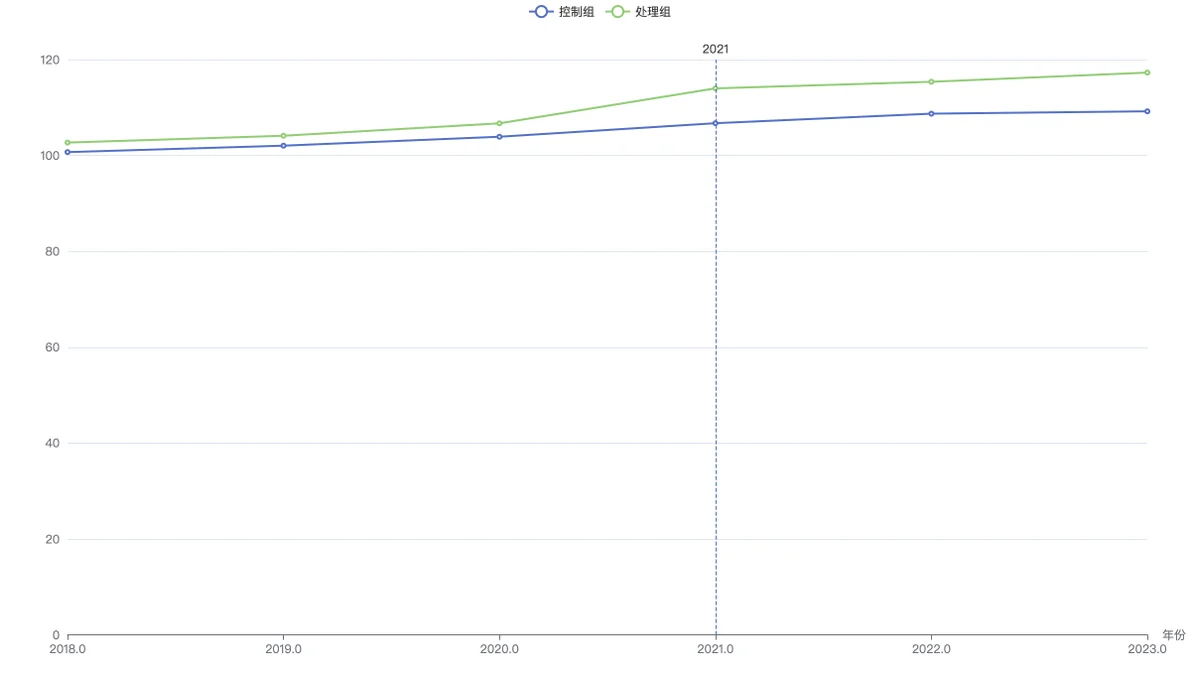
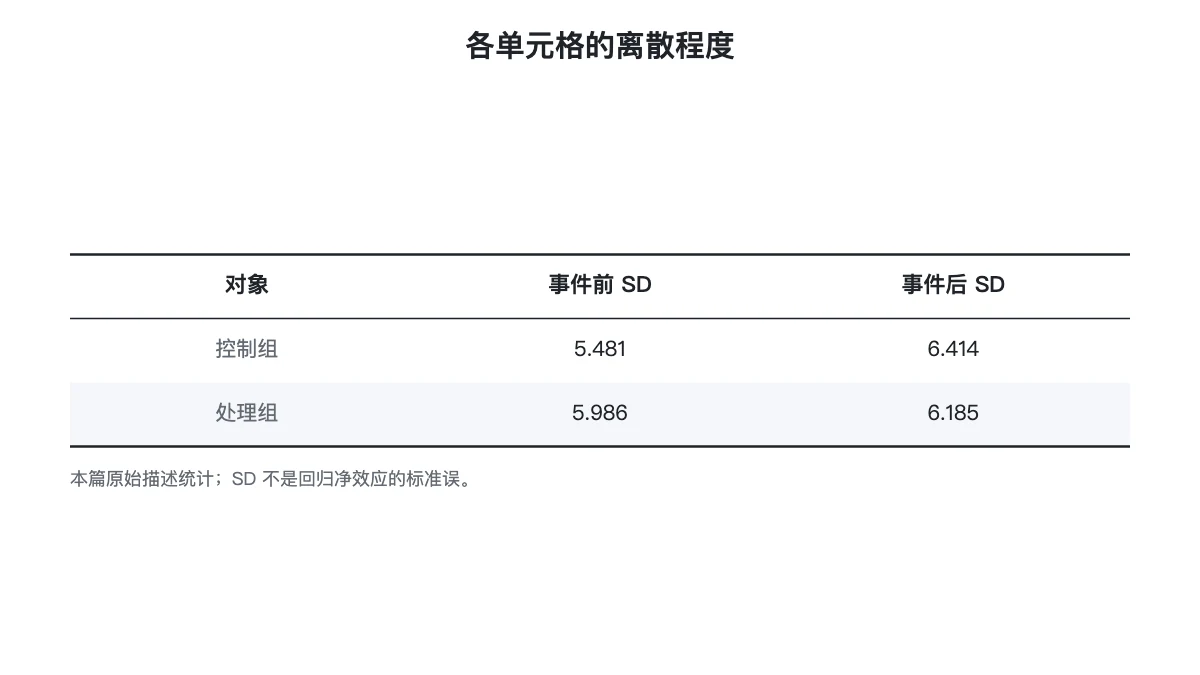
原始均值图用于核对组间轨迹,无法直接抄成控制企业规模后的动态系数。下表补充四个单元格的离散程度,与均值图展示不同信息。
主表回答平均效应有多大,动态效应回答效应何时出现、事前是否平稳。两者要一起写,只给其中一个都不完整。
稳健性表怎么并列
稳健性表把主设定与三种变式并排,读者能看到结论是否随设定漂移,本站这张表给出下面四行:
| 设定 | 净效应 | 标准误 | 95%CI | p |
|---|---|---|---|---|
| 主设定(含企业规模,按企业聚类) | 同主表 | 0.687 | [2.883, 5.644] | 显著,见星号 |
| 去掉全部控制变量 | 5.044*** | 0.825 | [3.386, 6.702] | 显著,见星号 |
| 标准误改为 HC1 | 4.263** | 1.284 | [1.736, 6.790] | 0.001 |
| 安慰剂:事件时点前移至 2019,仅用事件前样本 | 0.473 | 1.079 | — | 0.663 |
去掉控制变量后净效应变大,正文要解释控制变量的作用,并检查企业规模是否受处理影响,受影响的控制变量会成为坏控制。HC1 下点估计不变、标准误变大但仍显著;安慰剂未显著只提供一项证伪式检查,无法证明事前趋势或其他混杂已被排除。
错误写法和规范写法
| 常见写法 | 规范写法 |
|---|---|
| 平行趋势检验通过 | 写出事前联合检验的 F 与 p,未发现违背平行趋势的证据 |
| 政策使生产率提高 | 在平行趋势成立的前提下,处理组较对照组更高,与政策效应相容 |
| 稳健性良好 | 去控制变量、HC1、安慰剂各占一行,逐行列出系数与 p |
怎么确认主表和稳健性表写对了
- 主表观测数与卡一的分组汇总一致,个体数与观测行数没有混写。
- 稳健性表的安慰剂一行只用事件前的样本,样本量因此少于主设定,表注里要写明。
双重差分论文常见错误
- 把默认时点当作制度事实:核对政策资料,必要时手填时点后重跑。
- 只留下显著的稳健性行:实际执行的比较应完整登记。
- 用未显著证明识别成立:检验有功效和适用范围,报告未检出与无法估计的区别。
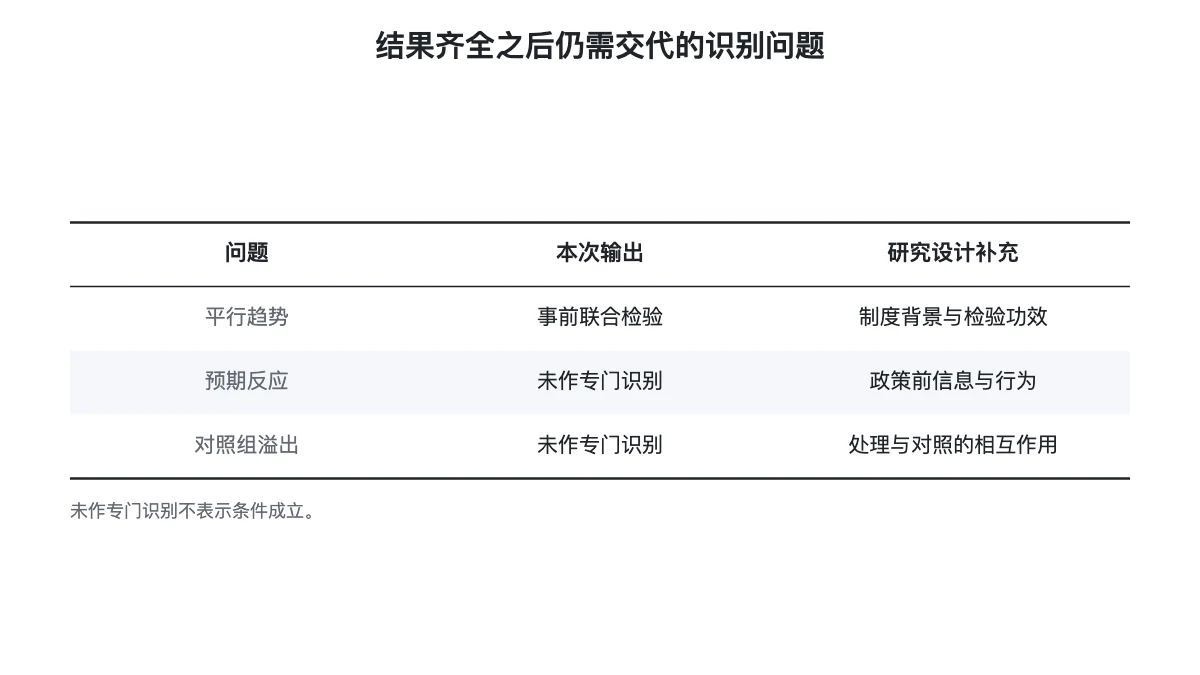
下图补充本次输出没有直接解决的识别问题。表格和图齐全仍不代表这些问题已得到数据支持,论文应单独说明设计依据。
延伸阅读
常见问题
- 双重差分论文的主表一定要放控制变量吗?
- 建议放,并在表注里写明。本例主表放入了 1 个控制变量企业规模,系数 2.045,它须是不受处理影响的变量。控制变量的系数可以不作解读,但要如实列出。
- 双重差分结果怎么写平行趋势?
- 写事前联合检验的统计量与 p 值,并附事件研究图。本例写作「未发现违背平行趋势的证据」即可,不要写成已经证明成立。
- 双重差分论文的安慰剂检验放在哪里?
- 放在稳健性表中,与主设定并列。本例把事件时点前移到 2019 年且只用事件前样本,伪净效应不显著,它未检出该伪时点下的显著差异,无法排除所有事前趋势解释。