面板数据是什么意思:长面板、短面板与平衡面板
更新于
面板数据是什么意思,简单说是 N 个个体在 T 个时期上的二维数据,比如多家企业连续多年的观测。同一企业的多期误差可能相关;把所有行当作独立记录会使推断失准。本站「面板模型」一次估出混合回归、随机效应和固定效应三套设定,并在第一张卡里把数据结构逐项写明。
很多人第一次接触会卡在几个词上:长面板、短面板、平衡面板、非平衡面板。下面按照现象、原因、解决步骤和确认判据说明,并用演示数据对照读报告。
面板数据是什么意思:读不懂的现象
核对的起点是数据来源。报告第一张卡会写出「观测总数 N×T」「个体数」「时期数」「面板类型」「平均每个体观测期数」几行,初学者常常不知道这些数字说明了什么,应先把结构表与原文件核对,再确认模型选择表中的各项检验是否实际执行;本例 BP-LM 有可估计的结果。
这张表描述结构,不进行因果识别。以下结果来自本站演示数据(模拟生成,不代表真实研究结论):本例从 30 家企业中整组随机抽取 26 家(随机种子 25),26 家企业,每家 8 期,共 208 条观测,平均每个个体 8.00 期,是平衡面板。
长面板、短面板与平衡面板的区别
平衡说的是每个个体是否覆盖相同的观测期,长短说的是时期与个体两个维度的相对规模。这两种分类可以交叉:一个时期较少的短面板,也可能因部分企业缺报而成为非平衡面板;它们不构成互斥的四类。
本例每家企业都保留完整时期,属于平衡面板。整组抽企业与随机抽行的后果不同:前者保留被抽中企业的完整时间轨迹,后者可能把部分时期抽掉。这里采用前者,不应把其他文章按行抽样产生的非平衡结构套到本例。
报告分别列出总体、组间和组内标准差。组间量反映企业平均水平的差异,组内量反映企业围绕各自平均水平的波动;固定效应的斜率主要利用后一部分。数据排成长表只是满足输入结构,无法保证关键自变量具有足够的企业内部变化。
解决步骤
- 先看第一张卡的面板结构表,确认个体数、时期数与是否平衡。
- 再看组间与组内标准差:固定效应只用组内变异,组内变异过小的变量在固定效应下会估计不稳定。
- 最后看三项检验:F 检验比较是否存在个体固定效应,Hausman 检验回答固定效应还是随机效应。
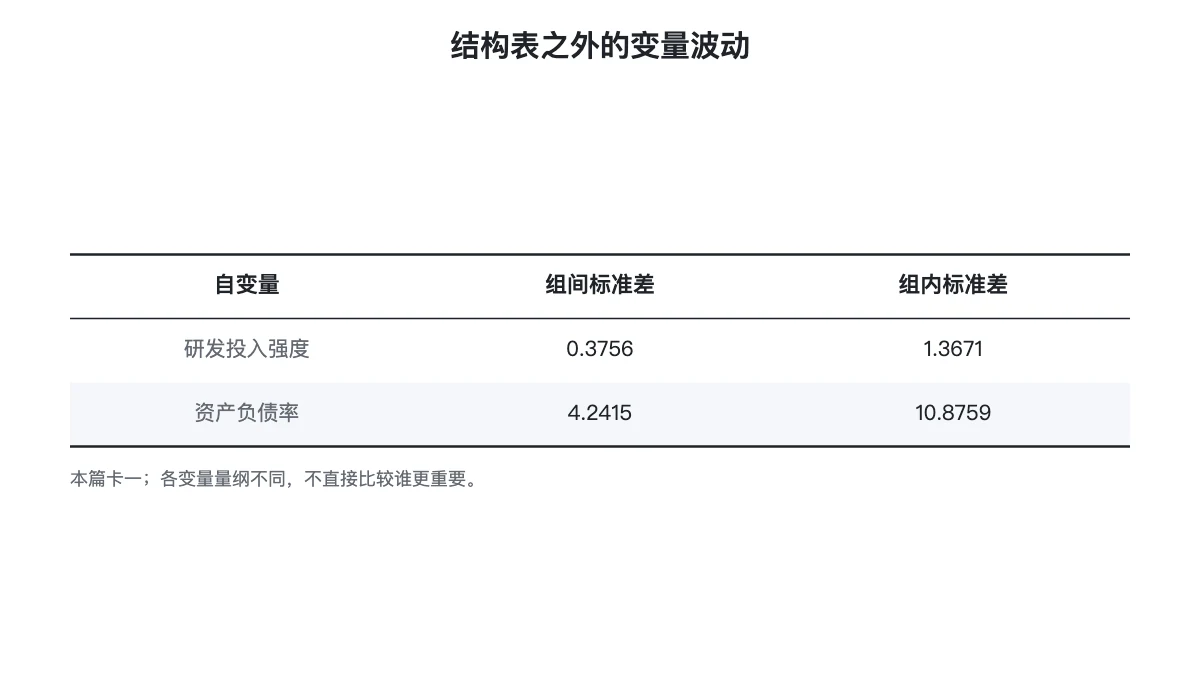
读懂结构后再选模型,不根据标题猜测样本类型。分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
怎么确认读对了
- 结构表显示平均期数等于每家企业实际期数,个体数乘以期数等于观测总数,说明本例没有缺期。
- 营业收入对数的组间标准差为 1.0180,组内为 0.1819;两者比较可见企业间水平差异较大,但无法据此判断变量之间的关系。
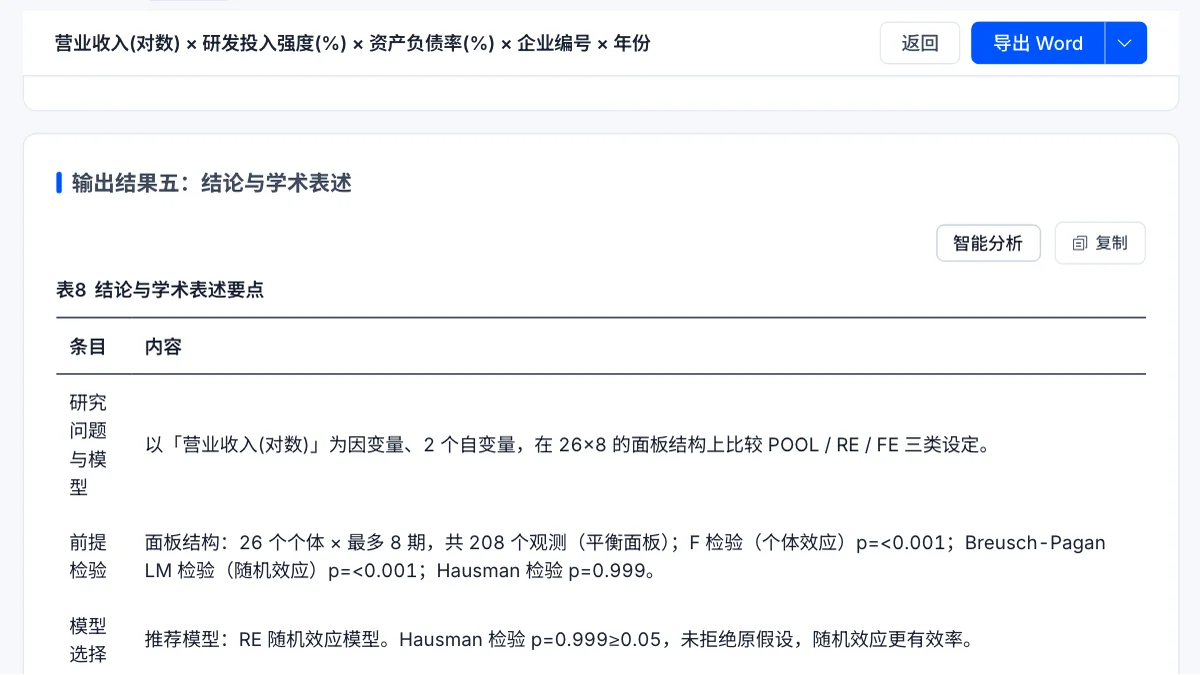
- F 检验统计量为 577.798,BP-LM 为 702.756,均达到显著水平;Hausman 的 p 为 0.999,未检出与随机效应限制不相容的证据,仍须依据研究背景论证该限制。
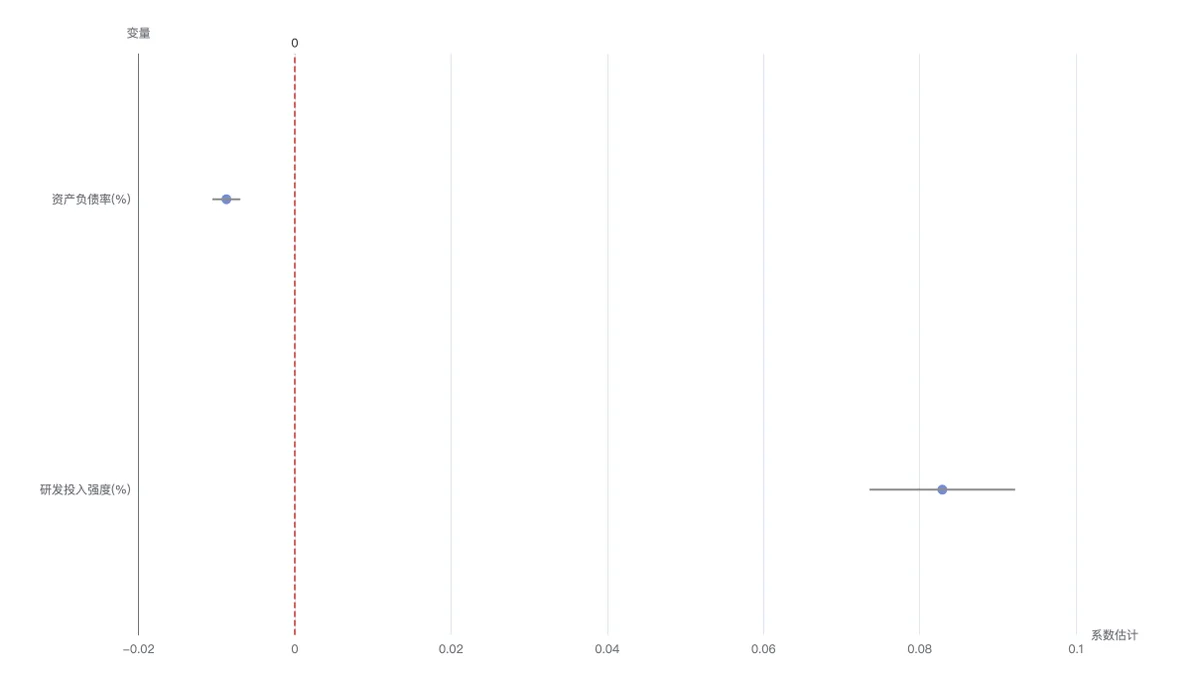
图中展示本例固定效应斜率及其区间。这个森林图回答变量的条件关联,无法用来判断面板是否平衡;平衡性应回到结构表核对。
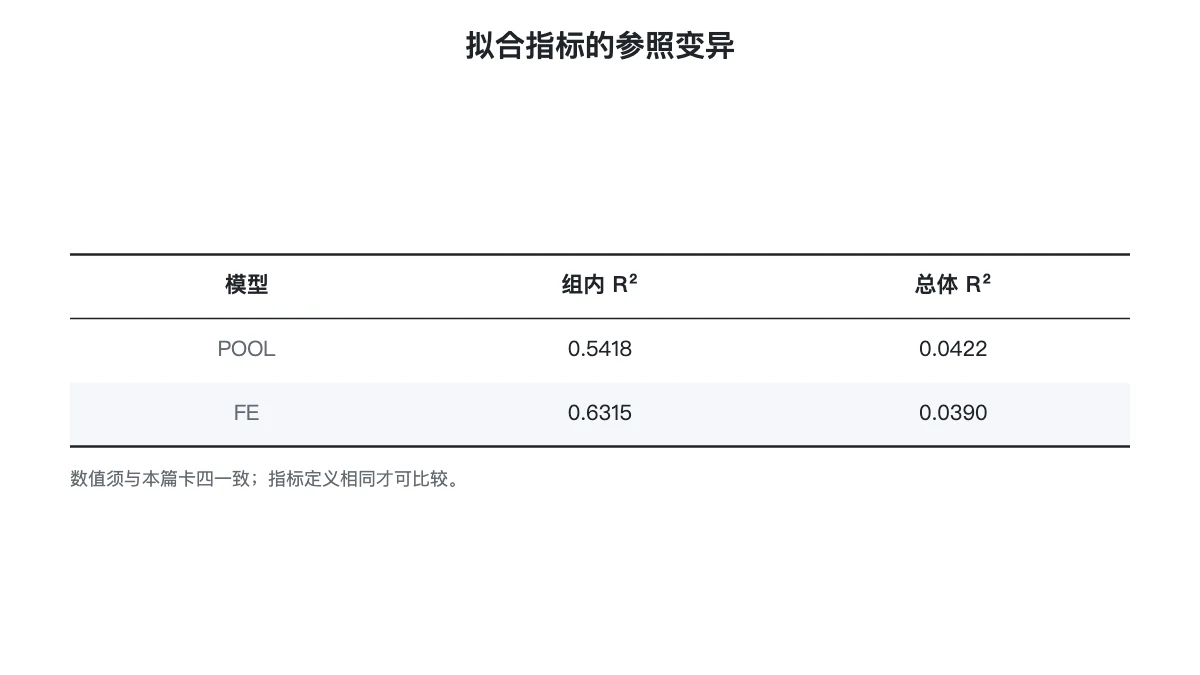
下表另列样本内拟合的不同参照,帮助区分模型的拟合对象。它们无法说明观测期是否完整,阅读时先区分结构检查与模型评价。
不随时间改变的企业属性,在企业内部去均值后变成常数零,无法用这种组内变化估出其斜率。这是识别信息不足,无法靠换一张系数表补回来;若另选模型,须同时接受并说明它的识别假设。
面板数据常见错误
- 把长短面板当成平衡性:时期少并不保证每个个体记录完整,分别登记两个维度。
- 将未显著解释成假设成立:检验未拒绝限制,仍并非限制已被验证;无法估计的检验须保留为无法判断。
- 把静态模型当作动态模型:因变量滞后项进入方程后,估计问题发生变化,无法沿用静态模型的解释。
下图展示本次结论卡中登记的结构与检验摘要,可核对观测数、个体数和期数。平衡性由这些记录共同判断,模型名称本身并不提供数据是否缺期的信息。
延伸阅读
常见问题
- 面板数据是什么意思?
- 面板数据是 N 个个体在 T 个时期上的二维数据,比如多家企业多年的观测。同一个体的多期观测可能相关,忽略这种结构会使独立误差的推断失准,应明确模型和标准误口径。
- 平衡面板数据和非平衡面板有什么区别?
- 平衡面板中个体的观测期覆盖一致,非平衡面板存在不同的时期覆盖。本例每家企业保留完整时期,BP-LM 已执行;本模块对非平衡结构不执行该项检验。
- 短面板是什么意思,对模型有什么影响?
- 短面板指个体数多、时期数少,常见的大 N 小 T 结构。T 很大而 N 很小时,大 N 小 T 的 GMM 渐近前提不成立,要改用固定效应或多变量时间序列模型。