Heckman 两步法怎么做:样本选择偏差与逆米尔斯比
更新于
Heckman 两步法怎么做?先用 Probit 估计「谁被观测到」的选择方程,由它生成逆米尔斯比(IMR),再把 IMR 放进结果方程做 OLS,用来修正只观测到一部分样本带来的选择偏差。本站「Heckman两步法」一次给出两个阶段的系数、识别前提诊断、选择偏误强度,以及忽略选择偏误前后的系数对照。
最容易被误读的有三处:排除性变量有没有、IMR 显著意味着什么、第一阶段的系数能不能当结论。下面按照数据、操作、结果和局限四步说明。
Heckman 两步法的数据与排除性变量
数据应为一行一人的表,因变量只对被选中的样本可观测。以下结果来自本站演示数据(模拟生成,不代表真实研究结论):全样本 500 条,参与工作的 306 人被选中,194 人未选中,选中率 61.2%,小时工资只对选中者可观测。
| 列名 | 角色 | 放进哪个区 |
|---|---|---|
| 是否参与工作 | 选择变量(0/1) | Y1(第一阶段,01变量) |
| 家庭其他收入(万元) | 仅进入选择方程的排除性变量 | X(第一阶段) |
| 小时工资(元) | 结果变量 | Y2(第二阶段,定量) |
| 受教育年限(年) | 结果方程的自变量 | X(第二阶段) |
为减少仅依靠函数形式识别,应论证一个只进入选择方程的排除性变量。本例将家庭其他收入作此设定,但这一限制仍需研究设计依据;IMR 与第二阶段自变量的共线性 VIF 为 1.02,没有严重共线。没有排除性变量时,识别只能靠函数形式,结论会变得不可靠。
Heckman 两步法怎么做
- 上传数据,在方法列表里找到「Heckman两步法」。
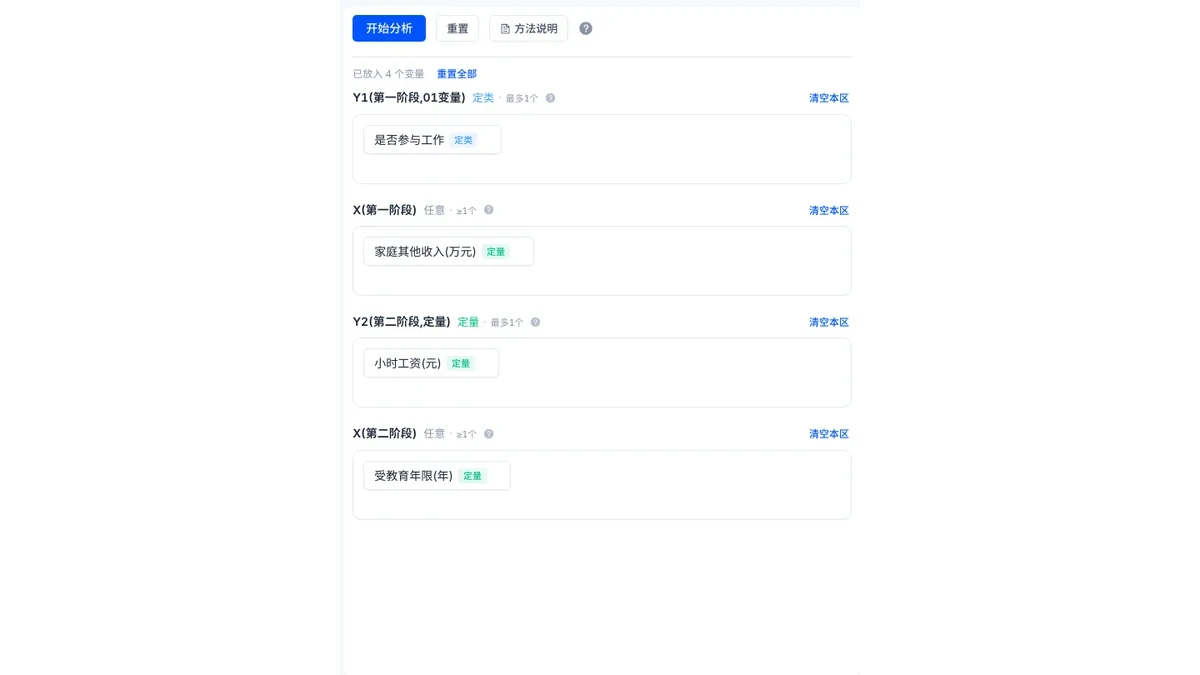
- 把是否参与工作拖进「Y1(第一阶段,01变量)」,家庭其他收入拖进「X(第一阶段)」,小时工资拖进「Y2(第二阶段,定量)」,受教育年限拖进「X(第二阶段)」。
- 点开始分析,报告依次给出模型结构与识别前提、两个阶段的系数表、选择偏误强度、效应量与对照、结论五张卡。
两个阶段的结果怎么读
第一阶段 Probit 选择方程中,家庭其他收入(万元)的系数为 -0.181(标准误 0.022,z=-8.195,p<0.001),截距 2.134,McFadden 伪 R² 为 0.1143,似然比 χ²(1)=76.311,选择方程有解释力。本篇用该阶段估计被观测概率并生成 IMR,负系数表达与较低参与概率的条件关联。若研究问题关注选择过程本身,第一阶段也可报告,但它不是结果方程中的工资系数。
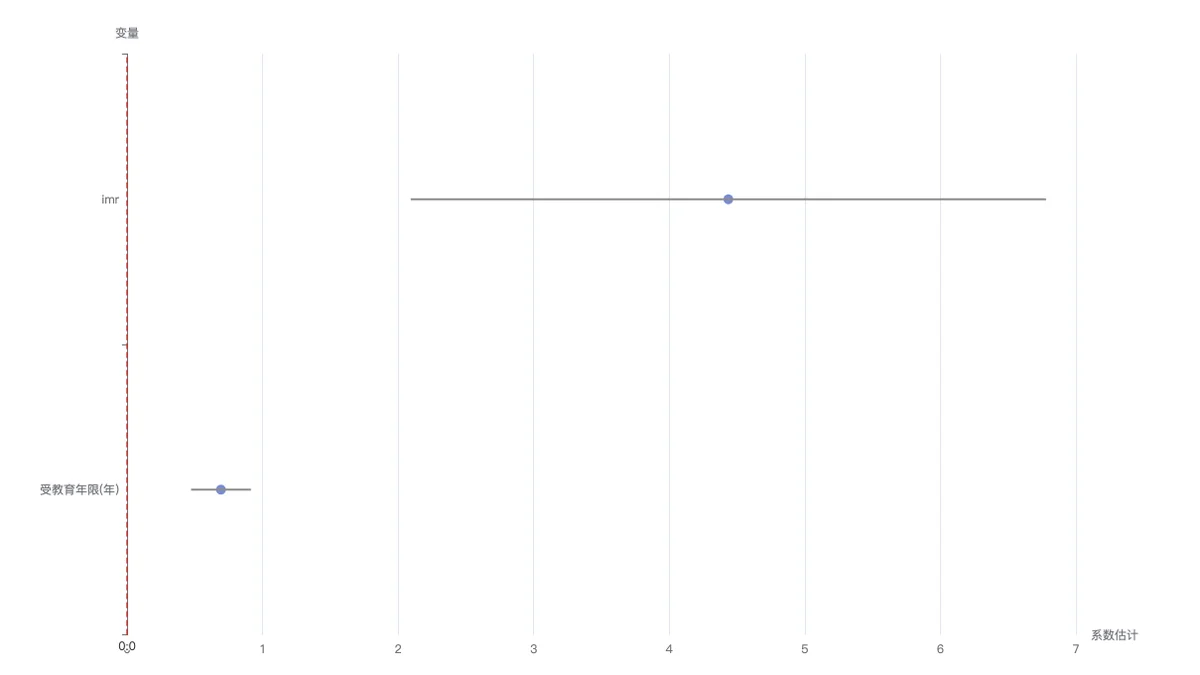
第二阶段 OLS 里,受教育年限(年)的系数为 0.693(标准误 0.112,t=6.179,95%CI [0.472, 0.913]),逆米尔斯比 IMR 的系数为 4.436(标准误 1.191,t=3.725,p<0.001),常数 25.782,R² 为 0.171。第二阶段的标准误采用 Greene(1981)校正,已纳入 IMR 本身是估计出来的这一事实。
样本选择偏差强度与修正幅度
IMR 系数为正,在联合正态及识别限制下,意味着选择方程与结果方程的未观测扰动呈正相关。它不等同于预测选择概率高的人必有更高工资,也不是选择变量对工资的因果效应。结构参数上,结果方程扰动项标准差 σ 为 5.855,两方程误差相关系数 ρ 为 0.758,属于强选择相关。忽略选择偏误的朴素 OLS 中,受教育年限的系数为 0.758,修正后为 0.693,差异 -0.065,相对偏离 -8.6%;常数项由 27.380 变为 25.782。
两种估计的差异依赖各自设定,无法把改动幅度当作识别是否正确的判据。本篇没有运行删除排除性变量的对照,所以不推断删除后的系数变化。
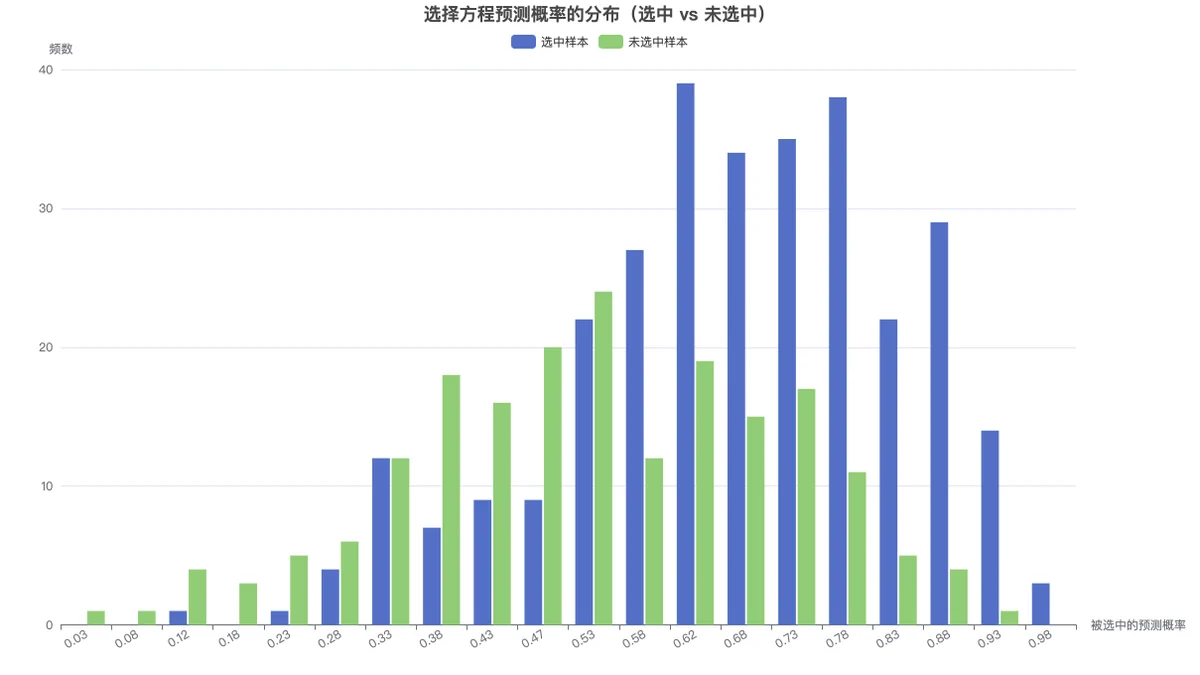
下图按区间比较两组的预测选择概率。它补充被观测机制的样本描述,展示的是概率分布,不能从柱高直接读出工资系数或校正幅度。
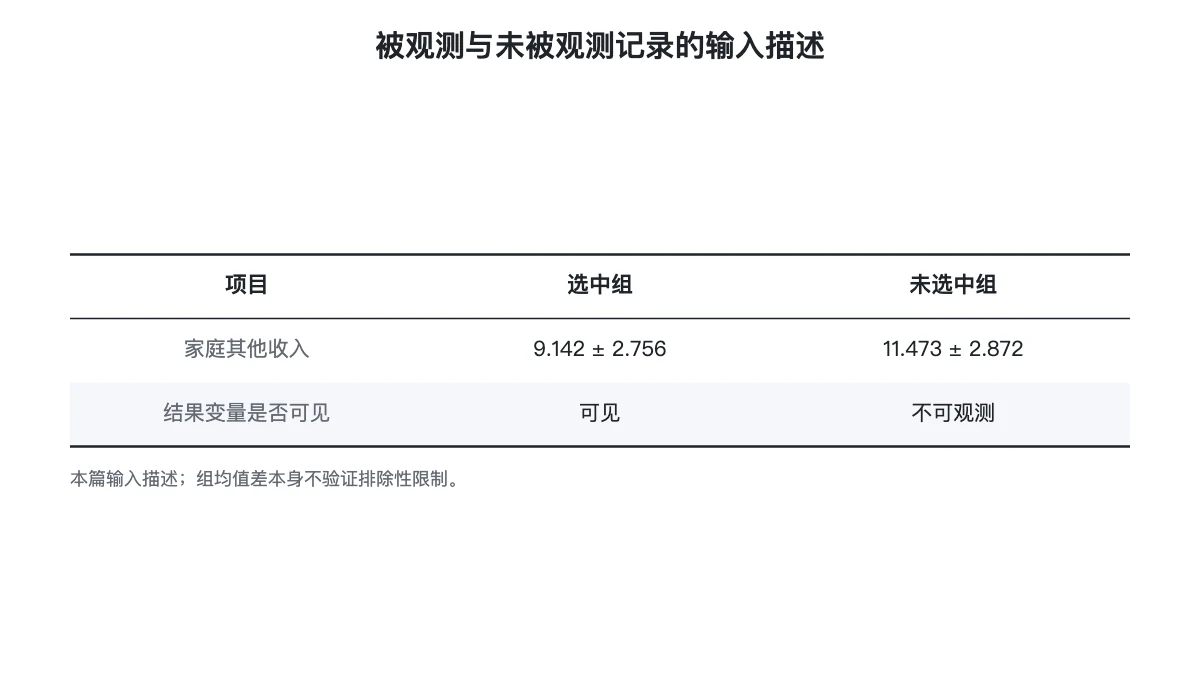
下表补充被观测和未被观测记录的输入差异。未选中记录的结果不可见是模型的观测结构,组间描述差异本身无法证明排除性变量有效。
论文里怎么写
可以照这个句式写,数字换成自己的结果:
小时工资仅对参与工作的 306 人可观测,故采用 Heckman 两步法修正样本选择偏差,选择方程以家庭其他收入作为排除性变量。第二阶段中逆米尔斯比的系数为 4.436(95%CI [2.092, 6.780],p<0.001),在联合正态假设下表明存在显著的样本选择偏差;修正后受教育年限的系数为 0.693(p<0.001),较未修正的 0.758 下降 8.6%。联合正态性假设无法检验,结论依赖该假设。
Heckman 检验常见错误
- 没有排除性变量:两阶段用同一个自变量时,识别只靠函数形式,结论可能翻转,模块照样出报告。
- 把第一阶段系数当工资系数:本篇第一阶段用于生成 IMR,它与结果方程中的工资关联是不同对象。
- 把 ρ 与 IMR 当两条独立证据:二者来自相关联的估计,报告时区分参数定义,不重复算作两份验证。
- 把偏误来源搞错:偏误来自自变量内生时应改用「两阶段回归」,处理个体自选的处理效应应改用「倾向得分匹配 (PSM)」。
开通会员后可导出 Word / PDF 报告、使用 AI 解读。导出后仍应核对本次样本与变量设置。
延伸阅读
常见问题
- Heckman 两步法的排除性变量是什么?
- 是只进入第一阶段选择方程、不进入结果方程的变量,它只影响是否被观测,不直接影响结果。本例用家庭其他收入(万元),识别靠这个变量,没有它就只能依靠函数形式。
- 逆米尔斯比显著就说明有样本选择偏差吗?
- 需以选择方程、排除性限制及联合误差分布等假设为条件解释。逆米尔斯比项显著提示该设定下的选择关联,无法把它当成对整套识别假设的验证。
- Heckman 检验的 ρ 与 IMR 系数是两条独立证据吗?
- 两者由同一第二阶段估计及尺度参数联系起来,并非相互独立的验证。报告应说明使用哪个参数和检验口径,避免把相关联的输出重复算作多份证据。