Logit 模型怎么做:二元选择模型的系数与 OR
更新于
Logit 模型怎么做?先确认二分类结果中哪一类被编码为事件,再选自变量,最后把系数解释为对数优势变化、把 OR 解释为事件优势的倍数。本站「逻辑回归」可展示系数和 OR,但模型中的条件关联仍需与因果解释分开。
Logit 模型的数据与事件方向
以下结果来自本站演示数据(模拟生成,不代表真实研究结论)。本篇随机抽取 255/300 行,比例为 85%,随机种子 23;列名与类别标签按计划改为企业研究的表达,数值未改变,不代表实际企业调查。
| 列名 | 模型角色 | 变量区域 |
|---|---|---|
| 是否创新 | 二分类结果 | 放入[定类]因变量Y |
| 董事长年龄(单位:岁) | 自变量 | 放入[定量]或[定类]自变量X |
| 企业规模 | 自变量 | 放入[定量]或[定类]自变量X |
| 研发人员占比(%) | 自变量 | 放入[定量]或[定类]自变量X |
本次事件类别留空,报告将“创新”编码为参照,将“未创新”编码为事件。因此后面的 OR 描述未创新的优势,正负方向与读者想研究创新时的直觉可能相反。应在进入结果表前确认这一点,把编码写进论文表注;想换方向时,在事件类别中填写目标类别后重新运行,原有数字随之属于另一种设定。
分析的记录单位也要说明。一行记录代表一个独立观测的设计前提,无法从两分类频数表本身得到证明;若同一企业跨期重复出现,普通截面模型的标准误口径需要另行评估。改名不会赋予演示数据真实的时间或聚类结构。
二元选择模型的操作步骤
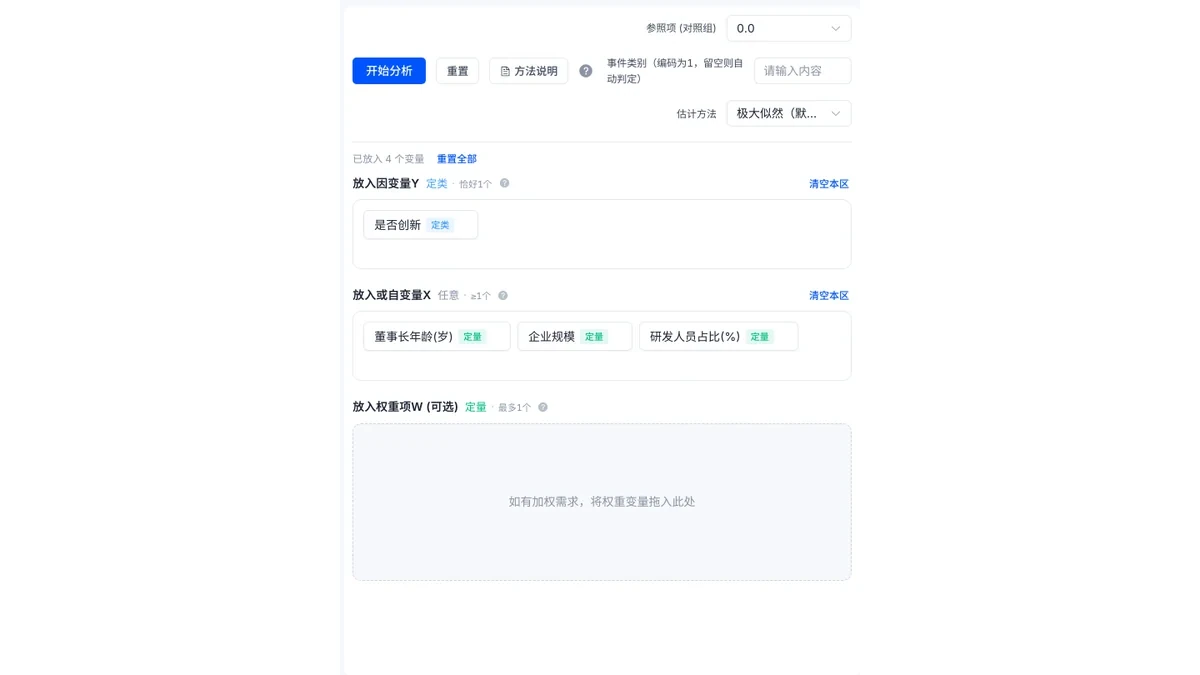
- 上传文件后选择「逻辑回归」,核对预览中的类别标签和连续变量单位。
- 按上表放入结果和自变量,本例保持事件类别留空,不填权重,沿用本次证据的自动编码。
- 点开始分析,先核对编码与有效样本,再查看系数、模型整体检验和分类图;调整输入之后重新运行。
分析和查看结果不用登录;开通会员后可导出 Word / PDF 报告、使用 AI 解读。
系数与发生比怎么读
董事长年龄的 B 为 -0.098,标准误为 0.016,OR 为 0.907,区间 [0.878, 0.937]。控制其余两项自变量后,年龄每增加一个原始单位,未创新的优势对应上述倍数;这不是概率减少同样比例,也不表明年龄变化导致结果改变。
企业规模的 OR 为 0.601,区间 [0.471, 0.767];研发人员占比的 OR 为 1.227,区间 [1.096, 1.373]。两项分别位于无关联参考值的两侧,表达的是给定模型中的方向;单位改变会改变单单位系数和 OR,所以表头的单位与解释中的单位要对应。
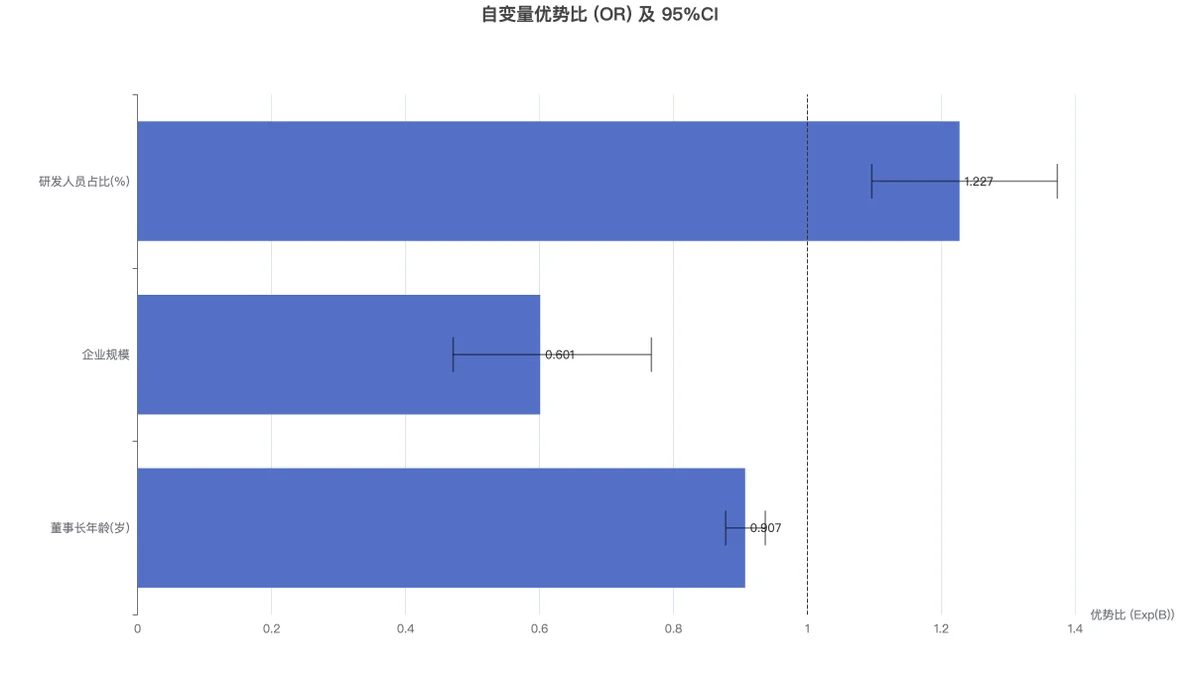
区间刻画估计不确定性,并不覆盖全部研究局限。遗漏变量、事件定义和样本选取带来的问题,无法通过图上区间较窄消除;若另一次运行未检出显著关联,应如实登记区间与原始 p 值,而不是把不显著改写成接受无关联。
诊断与预测表现分开看
本例最大 VIF 为 1.065,没有显示明显的共线性膨胀;这只是一项输入诊断。连续变量与对数优势的关系另由报告中的 Box-Tidwell 项检查,本次均未检出偏离,但未拒绝某项检验并不验证整个模型的设定。
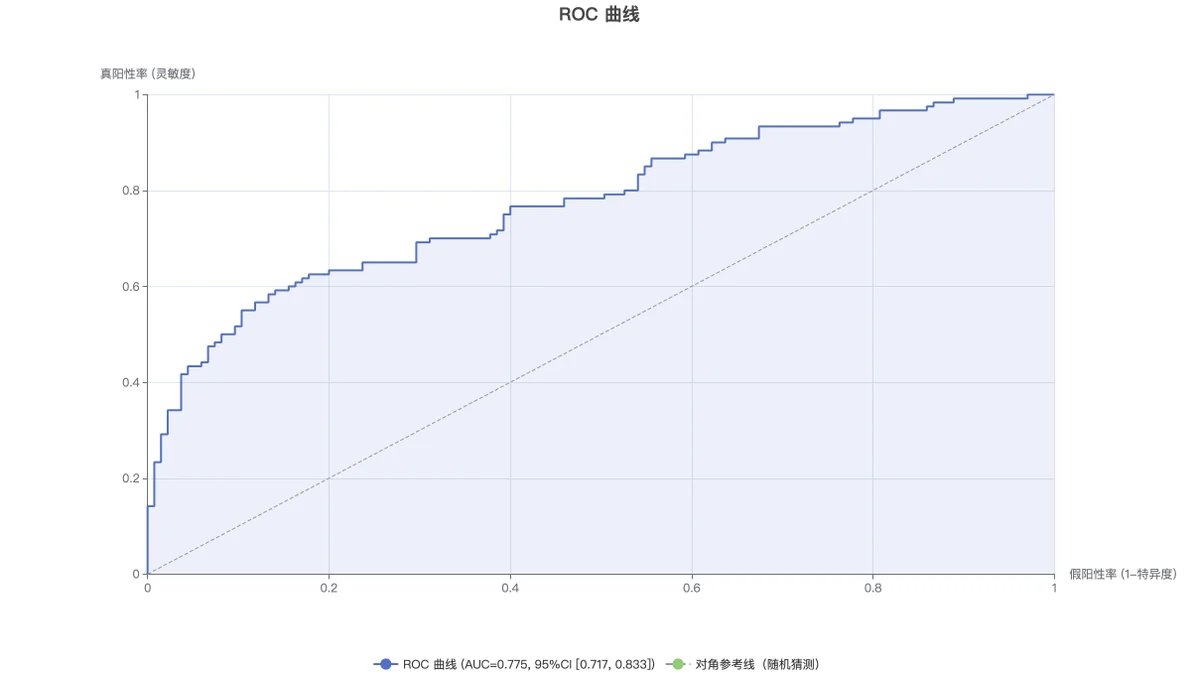
下图是本次运行的 ROC 曲线,用来查看阈值变化时的分类取舍。区分度与概率校准是不同问题,曲线位置无法证明预测概率已经准确,更无法把同一批数据上的拟合表现当作独立验证集的结果。
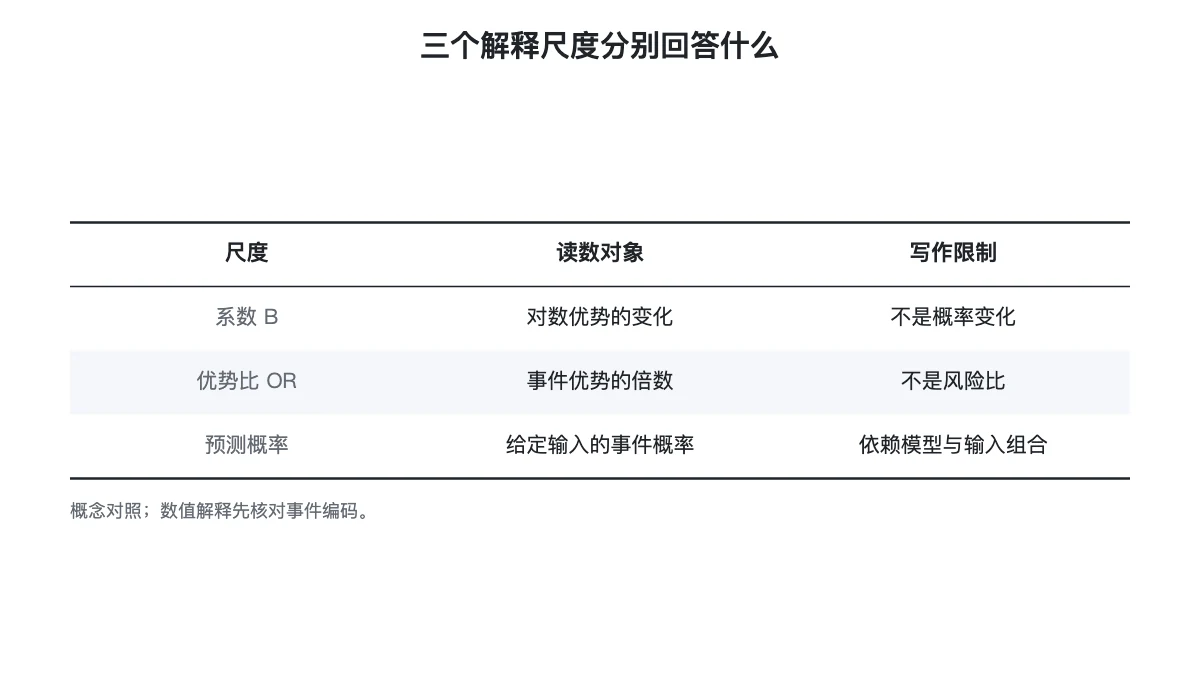
下面的概念图提醒写作时区分三个尺度。它不添加新的统计读数,而是帮助识别“系数”“优势”和“概率”在句子里是否被混用。
论文里怎么写
采用二元 Logit 模型描述是否创新与协变量的条件关联,本次事件编码为未创新,参照为创新。系数表报告 B、标准误、OR 与置信区间,解释限定在模型所含协变量及既定编码下;数据为模拟子样本,模型诊断与样本内分类表现不构成企业行为的因果证据。
这个句式先交代事件再交代模型,避免读者根据列名猜方向。正式论文应将模拟说明换成真实数据来源,并补充抽样、独立性以及模型选择的依据,无法直接把演示样本数当成自己的研究样本。
Logit 模型常见错误
- 看到是否创新就按创新解释:先检查本次事件编码,再决定文字方向。
- 把 OR 当概率比:保留事件优势的口径,需要概率时另看预测概率。
- 将样本内 ROC 当外部验证:交代图使用的样本,独立验证另有设计。
- 只报显著项:保留不显著与不可估计状态,说明模型和输入是否变动。
延伸阅读
常见问题
- Logit 模型中的事件一定是创新吗?
- 不一定。先核对本次报告的编码说明,本例自动把未创新编码为事件;若改动事件类别,必须重新运行,无法只把结果文字换成相反方向。
- 发生比能当成发生概率之比吗?
- 发生比对应的是事件优势的倍数,优势为概率除以非事件概率。它与风险比口径不同,尤其事件并不稀少时,应直接报告 OR 及其区间。
- 二元选择模型检验不显著如何写?
- 在预先指定水平下写未检出条件关联,并报告系数、区间及有效样本;估计失败或出现分离时,应保留不可估计的状态,无法当作无关联。